Внедрение локальных нейросетей на сервер компании (On-Premise)
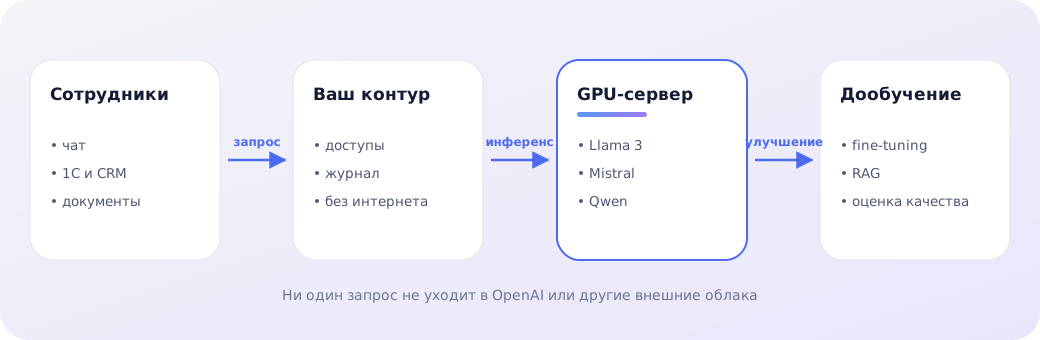
Для банков, финтеха, медицины и компаний с жёстким NDA: языковая модель работает на вашем сервере, данные не уходят во внешние облака.
- Данные внутри контура
Запросы и документы не покидают ваш сервер.
- GPU-сервер под задачу
Подбор железа под модель и нагрузку.
- Дообучение
Fine-tuning и RAG на ваших данных.
- Доступы и журнал
Кто и что спрашивал у модели — под контролем.
Сколько стоит
Локальная LLM под ключ
от 500 000 ₽- Подбор модели и GPU-сервера
- Развёртывание в вашем контуре
- Доступ для сотрудников и систем
Этапы работы
- 01Аудит
Разбираем процессы, находим ручную работу и потери. Бесплатно.
- 02План оцифровки
Собираем связку из наработок и доработок, фиксируем сроки и бюджет.
- 03Внедрение
Запускаем сайт, CRM, 1С и агентов, переносим данные, обучаем команду.
- 04Рост
SEO и реклама приводят клиентов, дашборд показывает, что приносит деньги.
ИИ без передачи данных наружу
Банку, клинике или компании с жёстким NDA нельзя просто отправить документы клиентов в ChatGPT. Решение — On-Premise LLM: открытая языковая модель разворачивается на GPU-сервере внутри вашего контура, а сотрудники и системы работают с ней так же, как с облачной. Данные не покидают периметр компании.
Облачная модель или локальная
| Критерий | Облачный GPT | Локальная Llama 3 |
|---|---|---|
| Где обрабатываются данные | На серверах провайдера | На вашем сервере |
| Персональные данные | Трансграничная передача | Внутри компании |
| Оплата | За каждый запрос | Сервер и поддержка |
| Качество в общих задачах | Выше | Ниже, догоняет на узких задачах |
| Дообучение | Ограничено провайдером | Полное, на ваших данных |
Подбор модели и железа
Сравниваем модели на ваших задачах и рассчитываем GPU-сервер под нагрузку — свой или в российском дата-центре.
Fine-tuning и RAG
Дообучаем модель на ваших данных и подключаем внутренние документы, чтобы ответы опирались на регламенты компании — как в RAG-ботах.
Инфраструктура и серверы — разработка сервисов и DevOps.
Смотрите также: ИИ для документов, ИИ в отделе продаж. Все форматы и цены — ИИ в ваш продукт.
Частые вопросы
Зачем локальная модель, если есть ChatGPT?
Когда данные нельзя отдавать наружу: клиентские данные банков и клиник, коммерческая тайна, документы под NDA. Локальная модель работает на вашем сервере, и ни один запрос не уходит в OpenAI или другое облако.
Как это связано со 152-ФЗ?
Отправка персональных данных в зарубежный сервис — это трансграничная передача со своими требованиями закона. Локальная модель снимает этот вопрос: данные обрабатываются внутри компании.
Какие модели можно развернуть?
Открытые модели: Llama 3, Mistral, Qwen и другие. Подбираем по качеству на ваших задачах, поддержке русского языка и требованиям к железу, учитывая условия лицензии модели.
Какой нужен сервер?
Сервер с GPU, мощность которого зависит от размера модели и числа одновременных пользователей. Считаем конфигурацию на этапе аудита — можно свой сервер или аренда в российском дата-центре.
Уступает ли локальная модель облачным?
Крупнейшие облачные модели сильнее в общих задачах. Но на узких задачах компании локальная модель с RAG и дообучением часто показывает достаточное качество — проверяем на ваших примерах до покупки железа.
Расскажите, что нужно сделать
Оставьте контакты или напишите в мессенджер: разберём задачу и предложим решение.
Телефон для связи8 (967) 858-85-55